多模态 YOLO 论文,它凭什么比单模态更好发?
多模态+好的包装=中稿=毕业
先问个有点扎心的问题:你最近投的 YOLO 稿,被拒过几次?我这边看到的情况是,单模态 YOLO 现在挺尴尬,编辑扫一眼标题里的 YOLO,可能还没看方法就已经想 Reject 了。方法做得再花,也架不住这四个字母自带的光环淡了。
但怪就怪在,同样是 YOLO,前面换成多模态,待遇完全不一样。同一个审稿人,对单模态皱眉头,对多模态却愿意多看一眼。这篇专栏就把这件事说透:多模态到底凭什么比单模态好发,以及光好发还不够,得会讲。我拿最近读的一篇论文 HyperDet 当教材,把它拆开给你看。
单模态 YOLO,难在哪
单模态 YOLO 的处境很具体:性能早就不拖后腿了,拖后腿的是投稿。编辑看到 YOLO 就累,审稿人觉得你又换了个注意力模块。RT-DETR 是条出路,但训练成本劝退了不少没有服务器的同学。
多模态为什么好发?因为它自带一个单模态给不了的东西,叫新颖性。你不用多强,两个模态往那一摆,故事就有了。可见光里看不清的,副模态里可能清清楚楚,反过来也一样。这种互补关系,审稿人一眼就认。
但新颖性只是入场券,不是保票。拿到券之后怎么讲,才是这篇要拆的东西。
这篇论文,拆开就两块
HyperDet 这名字唬人,跨模态超图融合。拆开看,就一个对齐模块加一个超图模块,中间一根因果箭头串起来。对齐模块干的是通道校准加空间校正,超图模块干的是图消息传递。
这俩都不是新东西。注意力校准、图传播,都是老演员了。那它凭什么发出来?答案不在模块里。
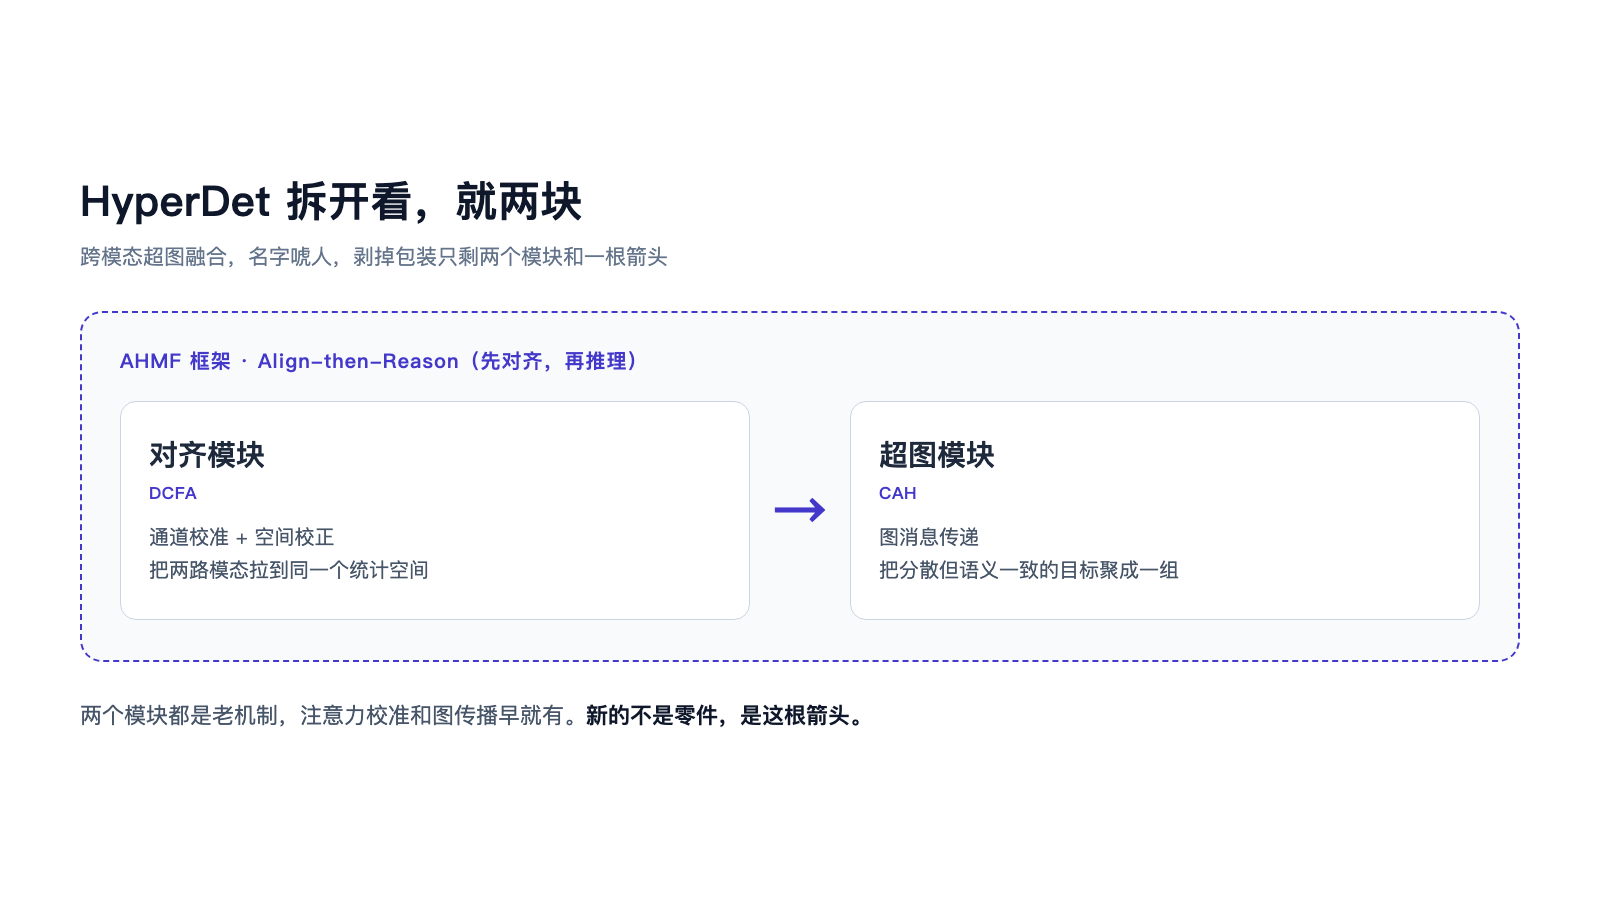
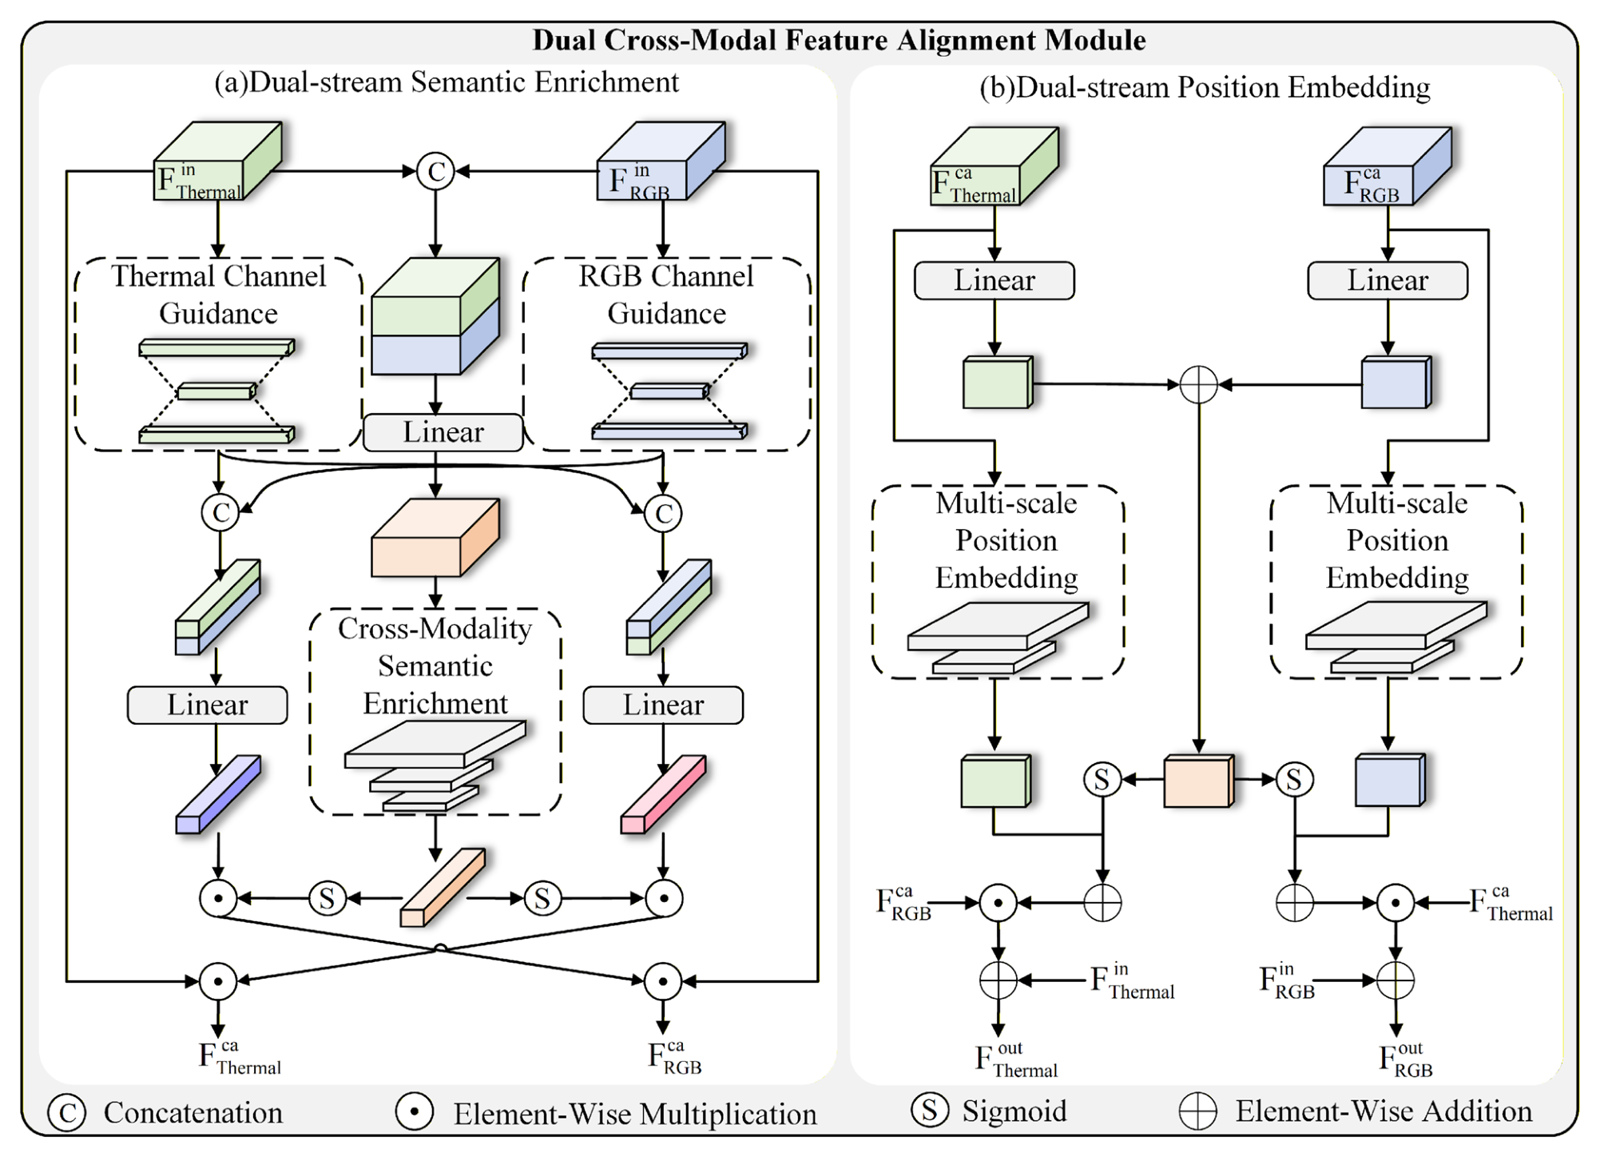
论文原文里,这根箭头是画得出来的。整个框架被拆成四步:收多尺度语义、对齐分布、并行高阶推理、再把超图特征注入金字塔。四步排成一条流水线,读者顺着箭头读下来,前面那步的必要性就不用再论证了。
它做对的那件事:把模块讲成范式
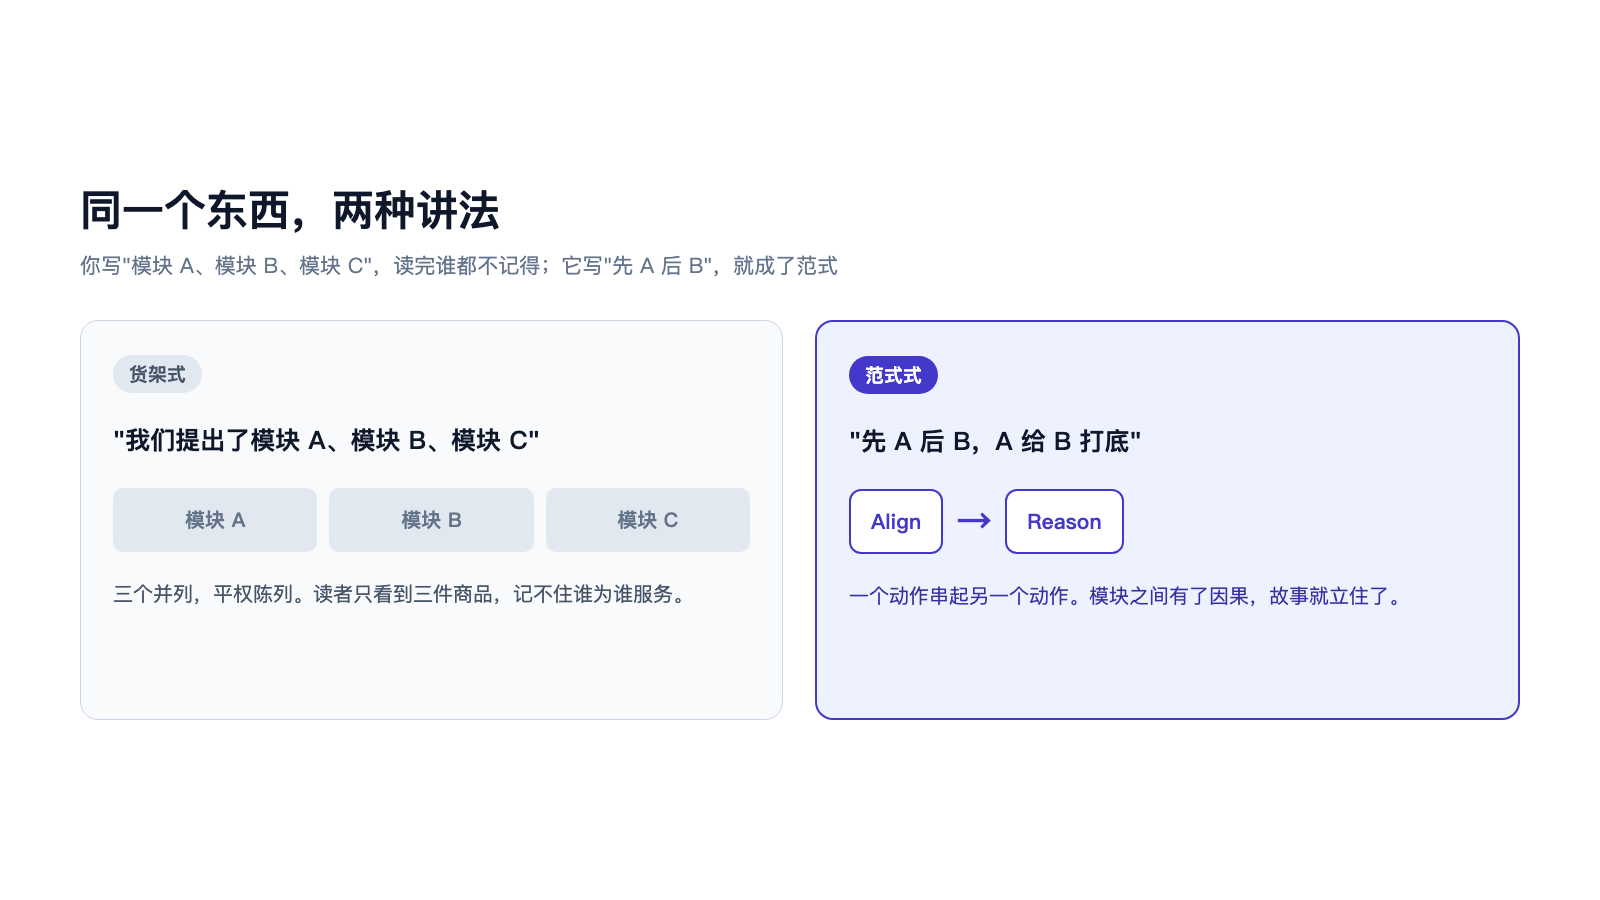
论文里反复出现一个词,Align-then-Reason,先对齐再推理。就这个词,把两个平级的模块变成了上下级。
想想你自己写论文是不是这样:"我们提出了模块 A、模块 B、模块 C",三个并列,读完谁都不记得。它不这样,它讲"先 A 后 B,A 给 B 打底"。同一个东西,两种讲法,第二种才叫范式。
你手里的 YOLOMM,资产不比它少,差的只是这层讲法。把"副模态生成、对齐、融合"串成一句话,它就有名字了。名字一旦立住,后面所有模块都是这个故事的注脚,而不是并列的功能点。
开场和收尾,都是能抄的
它的引入段就五句话,节拍固定:领域现状,However 一个局限,Additionally 另一个,To address 我的方法,最后甩一句数字。任何一篇多模态论文往这个模板里一套,骨架就立住了。
而且它很会合并对手。CNN、Transformer、Mamba,全被它塞进一个筐,叫 pairwise correlation。对手一合并,它自己就站到对面去了,干净利落。
收尾更聪明。主动写三条局限,再补一个部署章节,最后提一句未来能做 SAR。主动把边界讲出来,审稿人反而不追着问。
三个能直接照做的动作
这节最实在,照着做就能出东西。
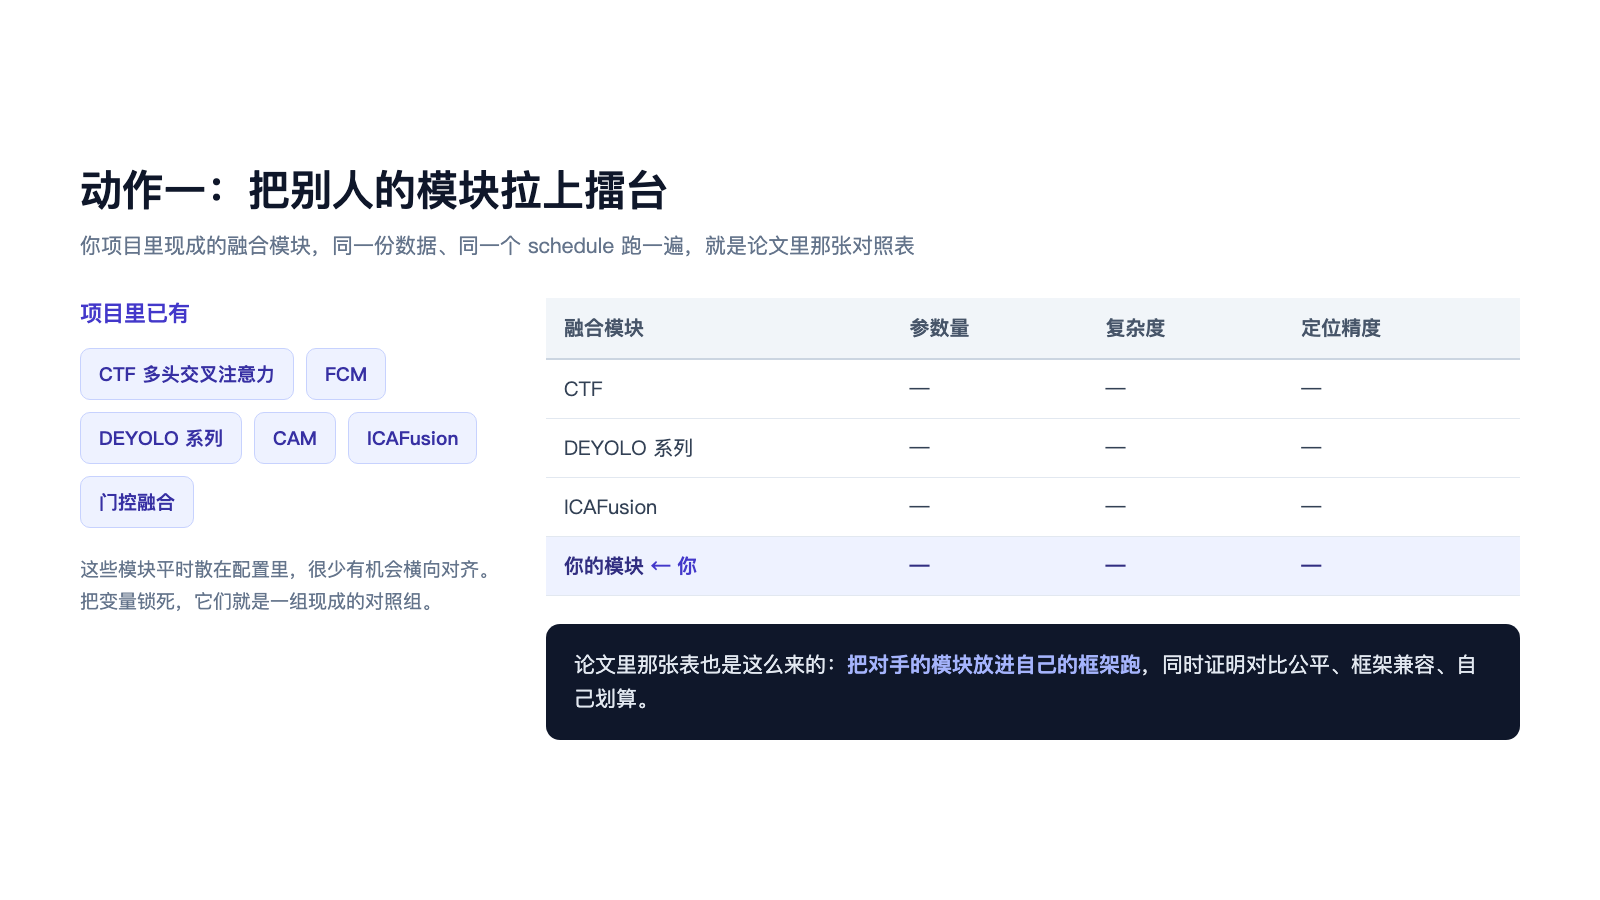
第一,它把别人的模块塞进自己的框架跑了一张擂台表,证明自己最划算。你项目里已经有 CTF、FCM、DEYOLO、CAM、ICAFusion 一堆融合模块,放同一份数据、同一个 schedule 跑一张表,就是现成的论文表格。
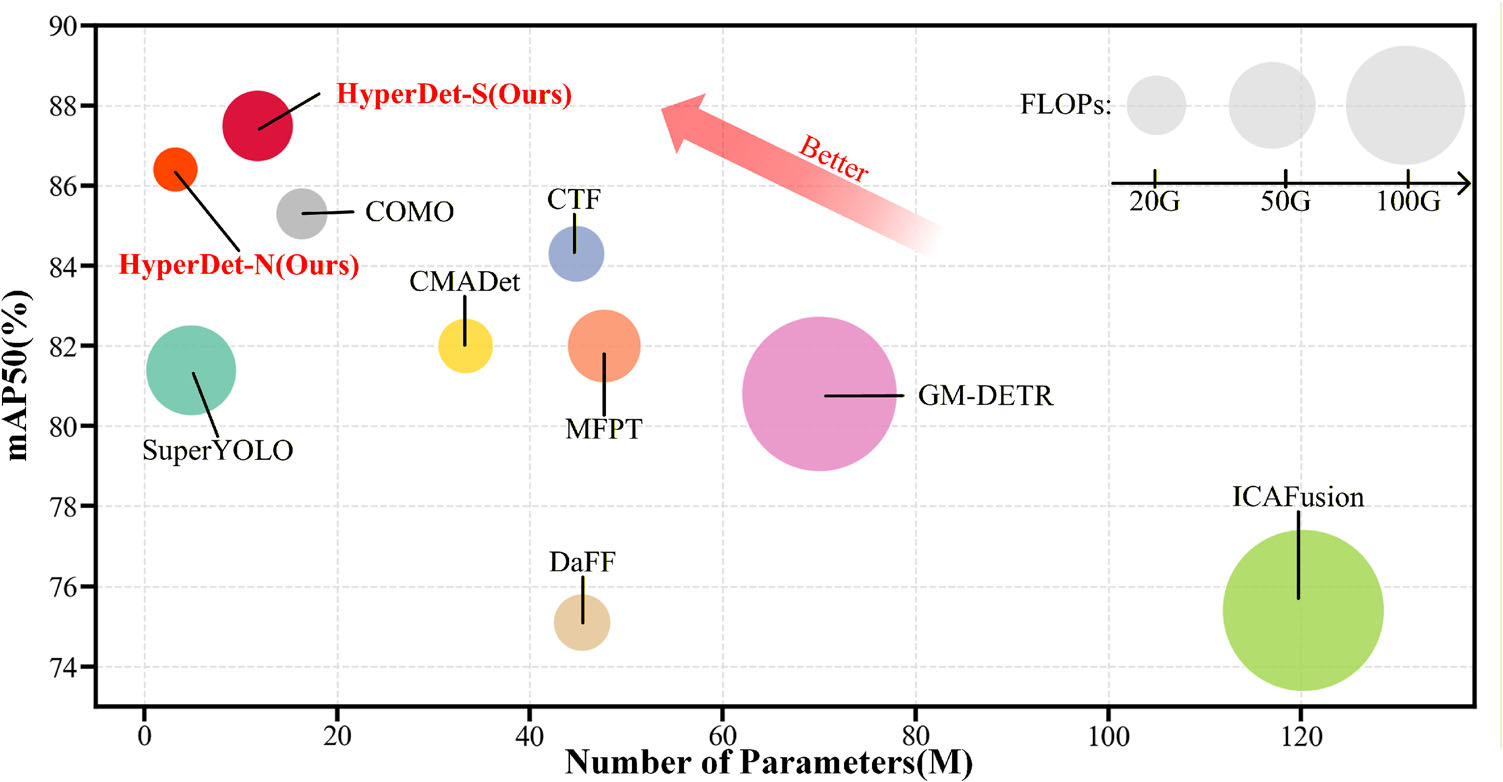
第二,讲效率别用形容词,一个复杂度符号加一张实测表。它的超图把复杂度从 O(N²) 压到 O(NM),再配一张延迟和显存表,效率主张就坐实了。项目里的复杂度分析模块能直接出这张表。
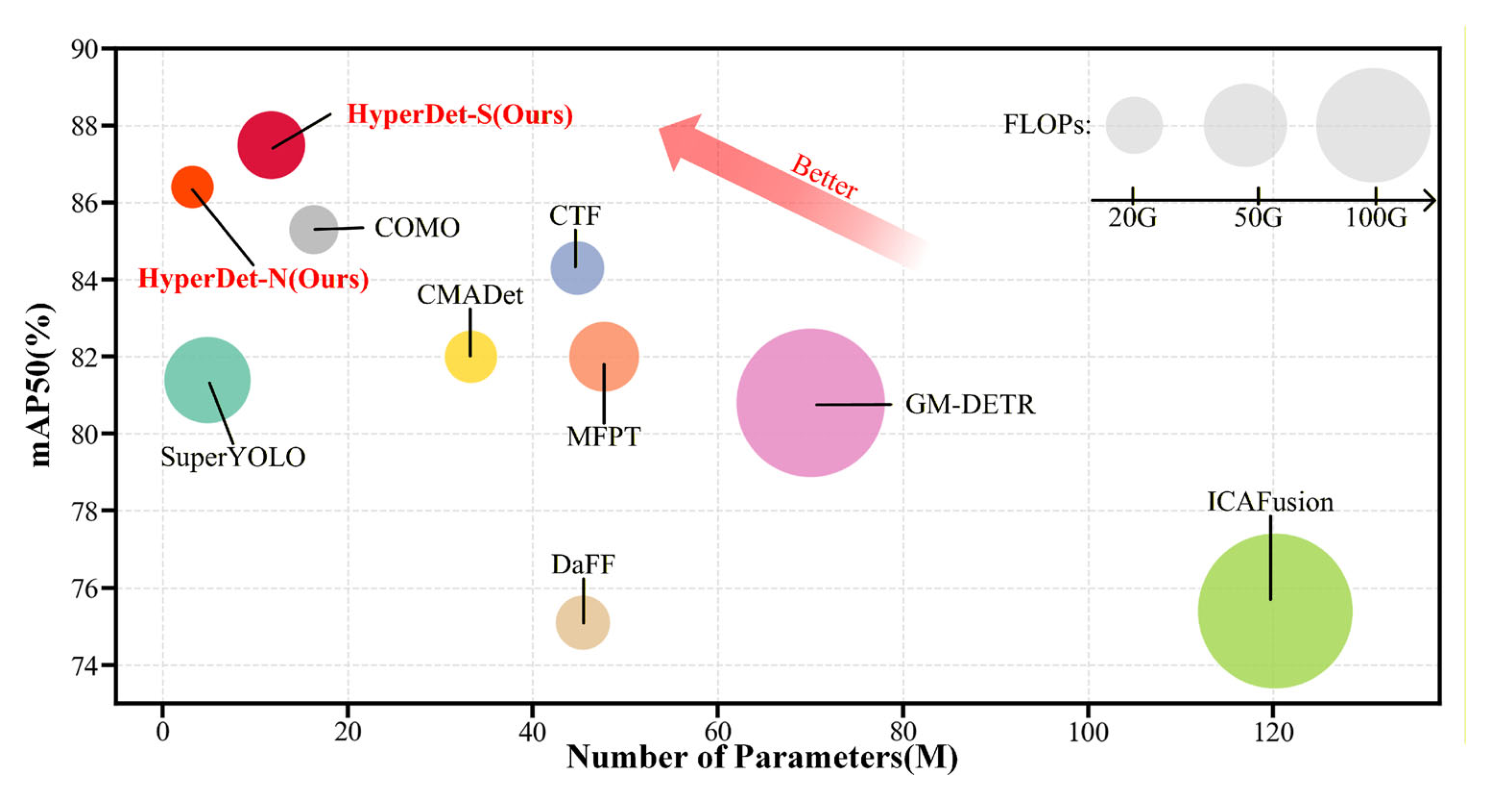
它那张权衡图也值得学:横轴参数量,纵轴精度,气泡大小是计算量,三个维度一张图讲完,还顺手把"谁在角落谁在中间"讲清楚了。
第三,把融合响应画成热力图,让黑盒看得见。你项目里的 Grad-CAM 可视化,能干同样的事。
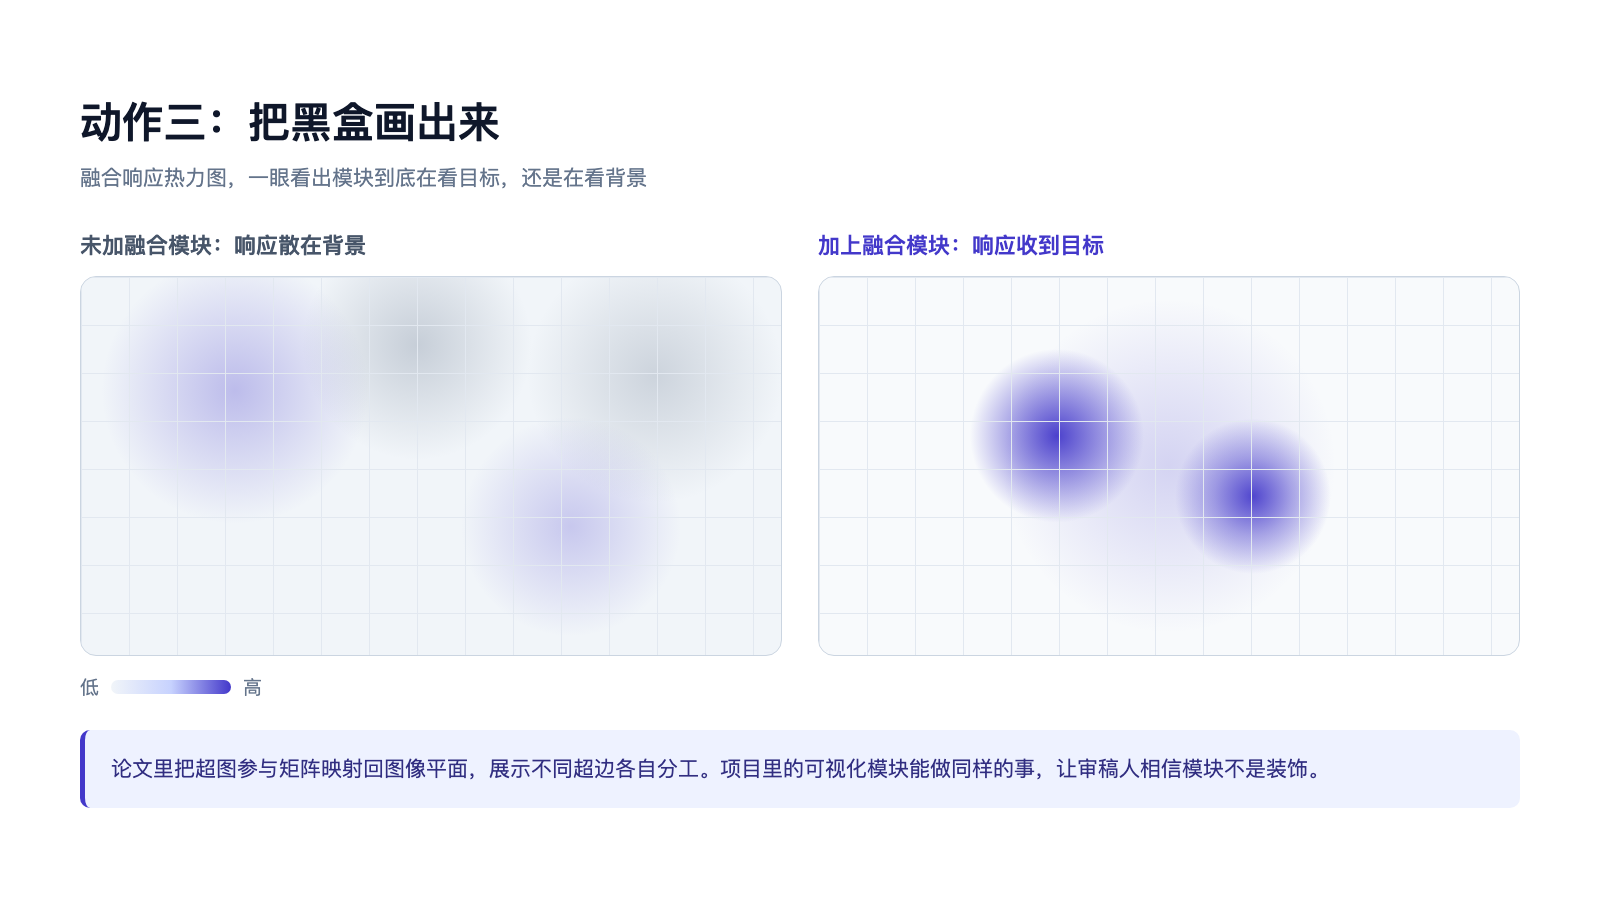
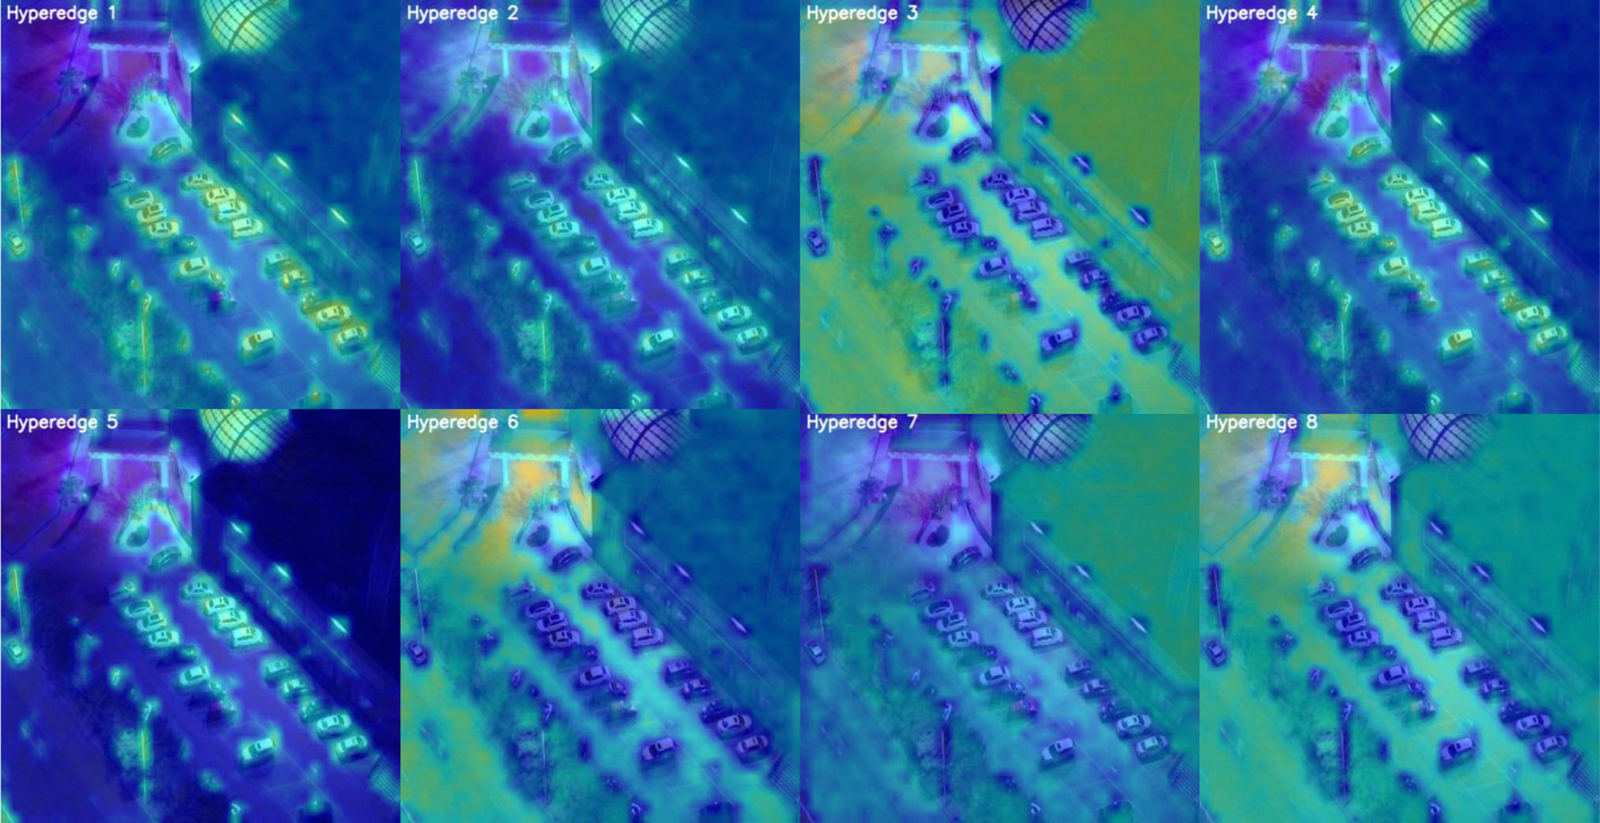
论文里就是这么干的:把超图的参与矩阵映射回图像平面,不同超边各自盯着不同的区域,有的管前景目标群,有的管道路背景。审稿人看到这张图,才会相信模块不是装饰。
收个尾
回到封面那句话。多模态让你进得了门,包装让你中得了稿,中稿才谈得上毕业。方法这一半,你大概率已经在了;讲法这一半,这篇论文教得很明白。
具体怎么套到你的任务上,动起手来才清楚。你手里正在做的多模态方法,是卡在方法还是卡在讲法?讨论留在专栏原文下面。
项目相关的东西放在主页,有需要自己去看:mmyolo.cn
原文刊于哔哩哔哩专栏,。去原文看讨论。图中标注「图片来源:HyperDet」的插图来自该论文。